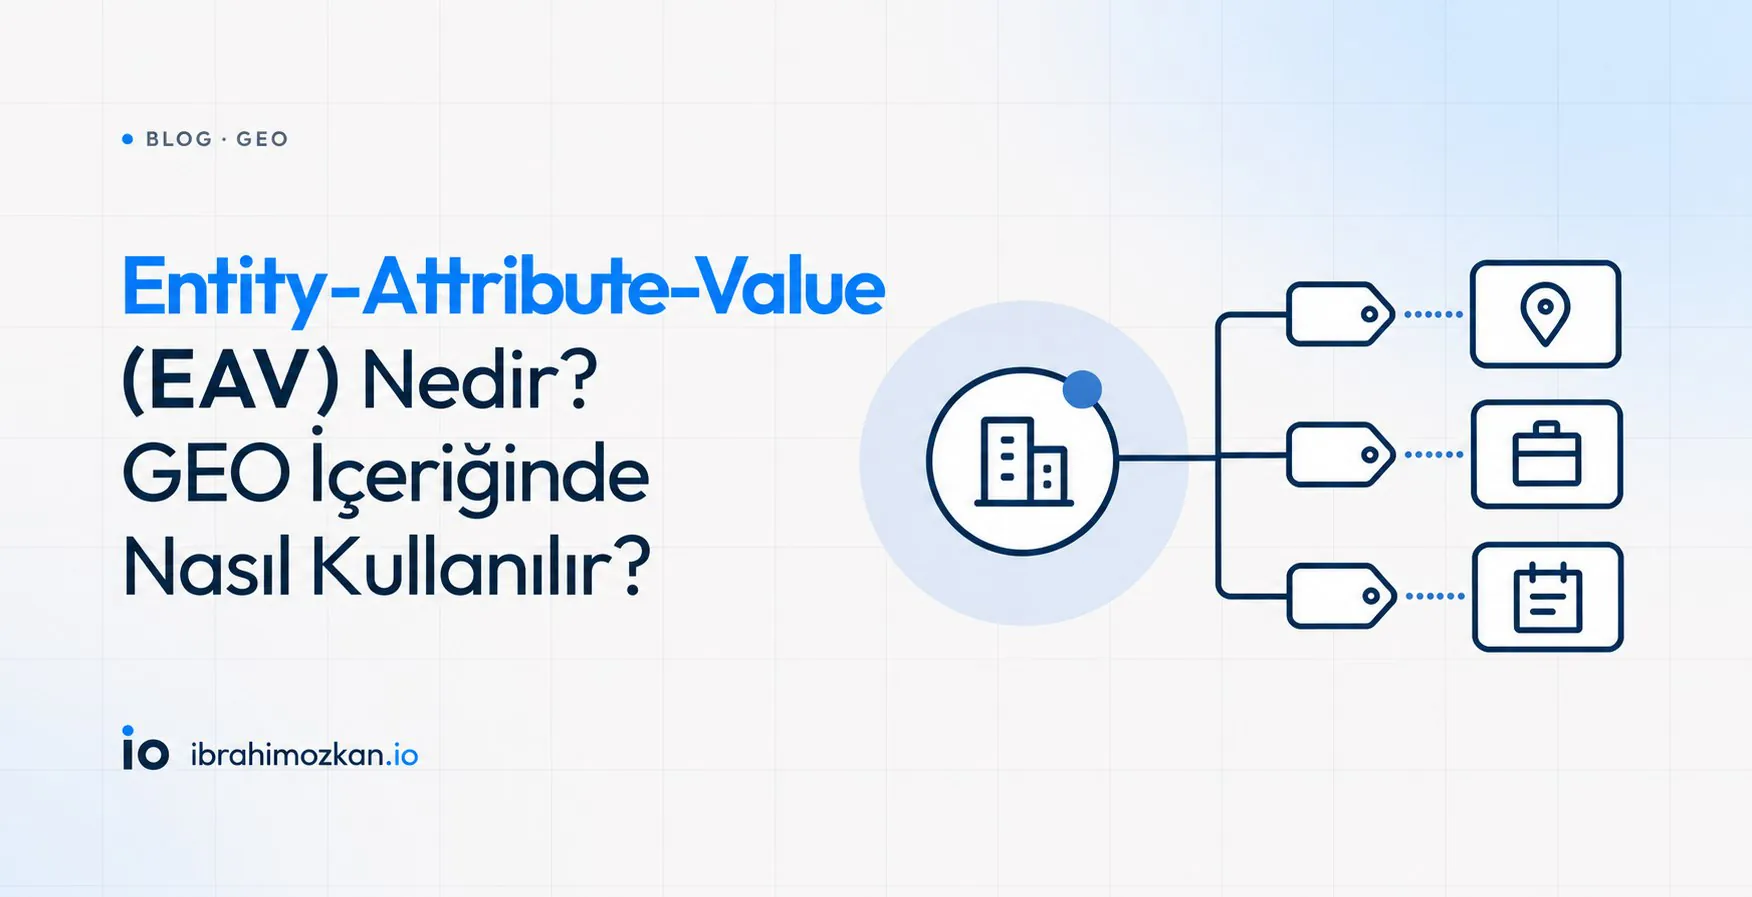
Entity-Attribute-Value (EAV) Nedir? GEO İçeriğinde Nasıl Kullanılır?
 İbrahim ÖzkanDijital Pazarlama Uzmanı
Meta ve Google reklamları, SEO, GEO, sosyal medya yönetimi ve ChatGPT Ads üzerine markalara danışmanlık veriyor. Yazılarında sahada uygulanan yöntemleri sade bir dille anlatıyor.
- Son güncelleme
- Okuma süresi
- 10 dk
Yapay Zeka ile Özetle
Prompt kopyalandı. Gemini’de metin kutusuna yapıştırıp gönderin.
Kısa Cevap
Entity Attribute Value (EAV), SEO ve GEO içeriğinde bir varlığı (entity) okurun sorusu için önemli nitelikleriyle (attribute) ve bu niteliklerin doğrulanmış değerleriyle (value) anlatma yöntemidir. GEO içeriğinde kullanmak için önce sayfanın ana varlığını belirleyin. Ardından sorgu bağlamına uyan nitelikleri seçin ve her değeri kaynağıyla birlikte açık cümlelerle yazın. Bu yöntem editoryal olarak içeriğin bilgi yapısını daha açık hâle getirir. Arama ya da yapay zekâ görünürlüğü üzerindeki etkisi platformlar tarafından EAV adıyla belgelenmiş değildir. Yöntem sıralama ya da alıntı garantisi de vermez.
EAV nedir?
EAV, bilgiyi varlık, nitelik ve değerden oluşan üç parçalı kayıtlarla ifade eden bir bilgi modelidir. Model veritabanı tasarımında uzun süredir kullanılır. Semantik SEO'da ise bir sayfanın hangi varlığı, hangi özellikleriyle ve hangi somut bilgilerle anlattığını planlamak için kullanılır.
Her EAV kaydı tek bir bilgi taşır. “İbrahim Özkan, uzmanlık alanı, GEO” kaydında İbrahim Özkan varlıktır. Uzmanlık alanı niteliktir. GEO ise bu niteliğin değeridir. Aynı varlık için eğitim alanı, çalıştığı pazar ya da sunduğu hizmetler gibi başka nitelikler de tanımlanabilir.
EAV modeli özellikle biyomedikal bilişimde seyrek ve değişken verileri modellemek için ayrıntılı biçimde uygulanmıştır. Dinu ve Nadkarni'nin biyomedikal veritabanları için hazırladığı EAV kılavuzu, bu yapıyı özellikle seyrek veriler için önerir. Seyrek veride olası nitelik sayısı çok yüksektir. Buna karşın tek bir kayıtta bu niteliklerin yalnızca küçük bir kısmı kullanılır. Bir hastaya uygulanabilecek klinik parametreler yüz binlerle ifade edilirken tek bir hasta için bunların az bir kısmı kaydedilir.
Arama tarafındaki bağlantı varlık odaklı yaklaşımdan gelir. Google, Bilgi Grafiği'ni (Knowledge Graph) 2012'de duyururken amacının gerçek dünyadaki varlıkları ve bunların birbirleriyle ilişkilerini anlamak olduğunu açıkladı. Duyuruya göre Bilgi Grafiği o tarihte 500 milyonu aşkın nesne ve bu nesneler hakkında 3,5 milyarı aşkın bilgi ve ilişki içeriyordu. Semantik SEO uygulayıcıları EAV'yi bu varlık odaklı bakışı içerik planına taşımak için kullanır. Google'ın sıralama sistemlerinde klasik bir EAV veritabanı kullandığına dair resmî bir açıklama bulunmuyor. Bu nedenle bu yazıda EAV, içeriği düzenleyen editoryal bir çerçeve olarak ele alınıyor. GEO açısından EAV, entity ve yapılandırılmış temsil katmanının bir parçasıdır. Bu katmanın bütün içindeki yerini GEO rehberinde görebilirsiniz.
Entity, attribute ve value arasındaki fark nedir?
Entity, anlatılan kişi, kurum, ürün, hizmet ya da kavramdır. Attribute bu varlığın bir özelliğini adlandırır. Value ise o özelliğin belirli bir varlık için aldığı somut bilgidir.
Nitelik bir bilgi kategorisidir ve tek başına bir şey söylemez. “Ölçüm metriği” ifadesi hangi metriğin kullanıldığını göstermez. Değer bu boşluğu doldurur ve iddiayı doğrulanabilir hâle getirir. Bir değer sayı, tarih, metin, adres ya da başka bir varlık olabilir. GEO Hizmeti örneğinde ölçüm metriği niteliği AI Presence Rate ve Overall Citation Presence gibi birden fazla değer alabilir.
Değer başka bir varlık olduğunda zincir uzar. AI Presence Rate kendi başına tanımı, hesaplama yöntemi ve ölçüm dönemi olan bir kavramdır. Bu durumda metriği ayrı bir varlık gibi ele alıp ilgili sayfada kendi nitelikleriyle anlatmak gerekir. Bu zincirler iç bağlantı planına da yön verir.
Veritabanındaki EAV modeli ile editoryal EAV nasıl ayrılır?
Veritabanı EAV modeli değişken ve seyrek verileri tablo yapısını değiştirmeden saklamak için tasarlanır. Editoryal EAV ise bir sayfada hangi varlığın hangi nitelikleriyle ve hangi doğrulanmış değerlerle anlatılacağını planlar. İki kullanım aynı üçlü yapıyı paylaşır. Amaçları ve başarı ölçütleri ise farklıdır.
Veritabanı tarafında modelin bedeli iyi bilinir. Dinu ve Nadkarni, EAV sistemlerinin güçlü bir metadata katmanı olmadan çalışamayacağını vurgular. Aynı çalışmaya göre nitelik odaklı sorgular geleneksel tasarımlara kıyasla üç ile on iki kat daha yavaş çalışabilir. Bu oran yazarların önceki karşılaştırmalarında incelenen belirli sistem mimarilerine aittir. Güncel her EAV veritabanı için genel bir performans katsayısı olarak okunmamalıdır. Editoryal kullanımda bu performans sorunu doğrudan geçerli olmaz. Onun yerine yanlış nitelik seçimi, doğrulanmamış değerler ve okurun sorusuyla ilgisiz bilgi yığını gibi içerik riskleri öne çıkar.
| Ölçüt | Veritabanı EAV modeli | Editoryal EAV |
|---|---|---|
| Temel amaç | Seyrek ve sık değişen verileri esnek biçimde saklamak | Bir varlığı okurun sorusuna uygun bilgilerle açıkça anlatmak |
| Kayıt birimi | Tablodaki bir satır | Bir cümle, tablo hücresi ya da yapılandırılmış veri alanı |
| Nitelikleri belirleyen | Sistemde ölçülen ya da girilen parametreler | Sorgu bağlamı ve okurun vermek istediği karar |
| Başarı ölçütü | Veri bütünlüğü ve sorgulanabilirlik | Doğruluk, kapsam ve anlaşılırlık |
| Başlıca risk | Karmaşık metadata ve yavaş nitelik odaklı sorgular | Doğrulanmamış değerler ve entity stuffing |
Tablodaki en belirleyici satır nitelikleri kimin seçtiğidir. Veritabanında nitelik listesi sistemin kaydettiği verilerden oluşur. İçerikte ise bu seçimi okurun sorusu yapar. Bu yüzden editoryal EAV çalışması sorgu analiziyle başlar.
EAV ile semantic triple aynı şey midir?
EAV ile semantic triple aynı şey sayılmaz. İkisi de bilgiyi üç parçalı bir yapıyla ifade ettiği için sık karıştırılır. EAV tek bir varlığın niteliklerini ve değerlerini tanımlamaya odaklanır. Semantic triple ise özne, yüklem ve nesne biçiminde hem varlıklar arasındaki ilişkileri hem de bir varlığa ait literal değerleri temsil edebilir.
W3C'nin RDF 1.1 standardına göre bir üçlüde nesne bir kaynak adresi (IRI), bir değer (literal) ya da boş düğüm olabilir. Bu yüzden editoryal bir EAV ifadesi RDF'de özne, yüklem ve nesne üçlüsü olarak temsil edilebilir. Veritabanındaki bir EAV satırı ise kendiliğinden bir RDF üçlüsü sayılmaz. Öte yandan her üçlü bir niteliği tanımlamaz. “İbrahim Özkan, GEO Hizmetini sunar” cümlesi iki varlık arasındaki ilişkiyi kurar. Bu tür ifadeleri brief'te ayrı bir ilişki satırı olarak planlayın.
Sorgu bağlamı nitelik seçimini nasıl belirler?
Sorgu bağlamı, okurun o aramada hangi bilgiye ihtiyaç duyduğunu gösterdiği için sayfada öne çıkacak nitelikleri belirler. Aynı varlık farklı sorgularda farklı niteliklerle anlatılır. “GEO hizmeti nedir” sorusu tanım ve kapsam isterken “GEO hizmeti nasıl ölçülür” sorusu metrik ve yöntem niteliklerini öne çıkarır.
Google'ın yapay zekâ özellikleri belgesine göre AI Bakışları ve AI Modu bir yanıt oluştururken alt konular ve veri kaynakları genelinde birden fazla ilgili arama yapabilir. Google bu tekniğe sorgu genişletme (query fan-out) adını veriyor. Bu rehberin editoryal çıkarımına göre farklı sorgu ihtiyaçlarına karşılık gelen nitelikleri açık bölümlerde işlemek, her pasajın kendi bağlamını korumasına yardımcı olabilir. Google, EAV kullanımını sorgu genişletme için bir gereklilik olarak tanımlamaz. Bu yapı pasajın seçileceğini de garanti etmez.
Aşağıdaki örnekler aynı varlığın üç farklı sorguda nasıl farklı nitelikler gerektirdiğini gösterir.
- Tanım sorgusunda hizmetin ne olduğu, kapsamı ve kimler için uygun olduğu öne çıkar.
- Ölçüm sorgusunda kullanılan metrikler, sorgu sınıfları ve ölçüm dönemi öne çıkar.
- Seçim sorgusunda yöntem, kanıt türü ve raporlama biçimi öne çıkar.
Birincil ve ikincil nitelikler nasıl ayrılır?
Birincil nitelikler varlığı tanımlamak için hemen her bağlamda gereken temel özelliklerdir. İkincil nitelikler ise belirli bir sorguya, kitleye ya da karşılaştırmaya değer katan daha dar özelliklerdir. Sayfada önce birincil nitelikleri eksiksiz verin. İkincil nitelikleri yalnızca okurun kararını etkilediklerinde ekleyin.
Koray Tuğberk Gübür'ün EAV yazısında anlattığı semantik içerik ağı çerçevesi nitelikleri kök (root), nadir (rare) ve benzersiz (unique) olarak sınıflandırır. Kök nitelikler bir varlık türünün hemen tüm örneklerinde bulunur. Nadir nitelikler yalnızca bazı örneklerde görülür. Benzersiz nitelikler tek bir varlığı benzerlerinden ayırır. Bu sınıflandırma sahada kullanılan bir uygulayıcı çerçevesidir ve Google'ın yayımladığı bir standart olarak sunulmamalıdır.
Bir GEO hizmeti sayfasında hizmetin kapsamı ve süreci kök nitelik sayılabilir. Ölçümün hangi sorgu sınıflarıyla yapıldığı daha az sayfada yer alan nadir bir niteliktir. Hizmeti sunan kişinin kendi süreç modeli benzersiz bir nitelik olabilir. İbrahim Özkan'ın GEO hizmetinde kullandığı Keşif, Denetim, Strateji, Uygulama, Ölçüm ve Yeniden yapılandırma aşamaları bu türe bir örnektir.
Önemli nokta
Bir niteliğin nadir olması onu tek başına değerli yapmaz. Nadir bir nitelik okurun sorusunu yanıtlamıyorsa sayfaya eklemeyin. Önceliği her zaman sorgu bağlamı ve değerin doğrulanabilirliği belirler.
Sayfa brief'inde EAV nasıl kullanılır?
Sayfa brief'inde EAV, yazara hangi varlığın hangi niteliklerle ve hangi kaynaklı değerlerle anlatılacağını gösteren bir tablo olarak kullanılır. Bu tablo yazım başlamadan hazırlanır. Tablodaki her satır bir başlığa, paragrafa ya da tabloya bağlanır.
- Sayfanın ana varlığını ve bu varlığın türünü tek cümleyle yazın.
- Birincil sorguyu ve sorgu genişletmesinden çıkan alt soruları listeleyin.
- Her alt soru için gereken nitelikleri belirleyip birincil ya da ikincil olarak işaretleyin.
- Her niteliğin değerini birincil bir kaynaktan doğrulayın ve kaynağı tabloya ekleyin.
- Her satırı hedef başlığa, paragrafa ya da tabloya atayın.
- Değeri doğrulanamayan nitelikleri metne almayın ve kanıt eksiği olarak raporlayın.
Bu akışın ilk adımı site genelindeki varlık tanımına bağlıdır. Ana varlığın bütün sayfalarda nasıl tutarlı tanımlanacağını entity optimizasyonu rehberinde bulabilirsiniz. Brief'teki EAV tablosu yazara yol gösterir. Nitelikler yine de paragraflarda neden önemli olduklarıyla birlikte açıklanmalıdır.
Uygulama notu
EAV tablosuna kaynak adında ayrı bir sütun ekleyin. Yazar her değeri bu sütundaki kaynağa bakarak aktarır. Kaynak sütunu boş kalan satırı yayından önce yeniden kontrol edin.
Entity doğruluğu nasıl korunur?
Entity doğruluğu, aynı varlığın aynı niteliği için aynı bağlamda ve aynı geçerlilik döneminde çelişmeyen, doğrulanmış değerler kullanılarak korunur. Fiyat, unvan ya da hizmet bölgesi gibi değerler zamanla değişebileceği için bu değerlerin hangi dönem için geçerli olduğunu belirtin. Bir çelişki fark edildiğinde önce doğru değer kaynağından teyit edilir. Ardından bu değerin geçtiği bütün sayfalar güncellenir.
Google, yapılandırılmış veri belgesinde bu işaretlemeyi sayfa içeriğini anlamak ve web ile dünya hakkında bilgi toplamak için kullandığını belirtiyor. Aynı varlık ve aynı dönem için farklı sayfalarda farklı değerler yayımlamak bu anlama sürecini zorlaştırabilir. Okur açısından da sonuç aynıdır. Hangi bilginin güncel olduğunu ayırt etmek güçleşir.
GEO ölçümünde bu konu Entity Accuracy metriğiyle izlenebilir. Bu metrik, yapay zekâ yanıtlarında bir marka ya da kişi hakkındaki bilgilerin doğru aktarılıp aktarılmadığını kontrol etmeye yarar. Yanlış aktarılan bir değer bulunduğunda önce sitedeki kaynak metin kontrol edilir. Sorun sitede değilse değerin dış kaynaklardaki tutarlılığı incelenir.
Tutarlılığı korumanın pratik yolu, hizmet adları, uzmanlık alanları ve metrik adları gibi sık tekrarlanan değerleri tek bir kaynak listede toplamaktır. Yeni sayfalar bu listeye göre yazılır. Bir değer değiştiğinde liste ve ilgili bütün sayfalar birlikte güncellenir.
EAV için yapılandırılmış veri zorunlu mu?
EAV'yi uygulamak için yapılandırılmış veri zorunlu değildir. Google, AI Bakışları ve AI Modu'nda görünmek için özel bir schema.org işaretlemesine gerek olmadığını açıkça belirtiyor. Yapılandırılmış veri kullanacaksanız işaretlemedeki bilgilerin sayfada görünen metinle eşleşmesi gerekir.
Schema.org işaretlemesi yine de EAV mantığıyla kolayca eşleşir. Öğe türü varlığa, özellik adı niteliğe, özelliğe verilen karşılık da değere karşılık gelir. Bu eşleşme editoryal bir yorumdur ve işaretlemenin arama sonucunda özel bir görünüm sağlayacağı anlamına gelmez. Google, zengin sonuç uygunluğu için genel yapılandırılmış veri yönergelerine ve türe özel yönergelere uyulması gerektiğini ayrıca belirtiyor.
EAV yanlış kullanıldığında ne olur?
EAV yanlış kullanıldığında metin okura yardım etmeyen nitelik listelerine ve SEO topluluğunda entity stuffing olarak anılan yapay varlık yığınlarına dönüşür. Bu durum okunabilirliği düşürür. Ayrıca Google'ın spam politikalarında anahtar kelime doldurma olarak tanımladığı manipülatif uygulamalara yaklaşabilir.
Google'ın spam politikaları anahtar kelime doldurmayı, sıralamayı manipüle etmek amacıyla sayfayı anahtar kelimeler ya da sayılarla doldurmak olarak tanımlar. Kelimelerin doğal olmayan biçimde tekrarlanması da bu tanımın örnekleri arasındadır. Entity stuffing Google'ın politika terimleri arasında yer almaz. Yine de varlık adlarını ve nitelikleri gerekçesiz biçimde tekrarlayan bir metin aynı soruna yol açar. Sık görülen hatalar şunlardır.
- Sorguyla ilgisi olmayan nitelikler yalnızca kapsam görüntüsü yaratmak için eklenir.
- Değerler kaynak gösterilmeden ya da tahminle yazılır.
- Aynı varlık adı her cümlede tekrarlanır ve metnin akışı bozulur.
- İki varlık arasındaki ilişkiler nitelik gibi sunulur ve semantic triple ile EAV birbirine karıştırılır.
- Yapılandırılmış veride sayfada görünmeyen bilgiler yer alır.
Uyarı
Varlık adlarını ve nitelikleri sayfaya liste hâlinde yığmak metni zayıflatır ve spam politikalarıyla çelişme riski taşır. Her niteliği yalnızca okurun sorusuna yanıt verdiğinde ve değeri doğrulandığında kullanın.
Kaynaklar
- Valentin Dinu ve Prakash Nadkarni, biyomedikal veritabanlarında EAV modellemesinin etkili kullanımına dair kılavuz, International Journal of Medical Informatics, 2007.
- Amit Singhal, Google Bilgi Grafiği duyurusu, Google Blog, 16 Mayıs 2012.
- Google Search Central, yapay zekâ özellikleri ve web siteniz, son güncelleme 10 Aralık 2025.
- Google Search Central, yapılandırılmış veriye giriş, son güncelleme 10 Aralık 2025.
- Google Search Central, Google web araması için spam politikaları, son güncelleme 28 Ağustos 2026.
- W3C, RDF 1.1 kavramları ve soyut sözdizimi, W3C önerisi, 25 Şubat 2014.
- Koray Tuğberk Gübür, SEO için EAV mimarisinin önemi, Holistic SEO, 2023.
Meta ve Google reklamları, SEO, GEO, sosyal medya yönetimi ve ChatGPT Ads üzerine markalara danışmanlık veriyor. Yazılarında sahada uygulanan yöntemleri sade bir dille anlatıyor.
İlgili yazılar

Perplexity Optimizasyonu: Kaynak Görünürlüğü ve Citation Nasıl İzlenir?
PerplexityBot erişimi, kaynak gösterim mantığı, marka bilgisi tutarlılığı ve citation ölçümüyle Perplexity görünürlüğünüzü nasıl test edeceğinizi öğrenin.

GEO için Entity Optimizasyonu: Markalar AI Sistemlerinde Nasıl Netleştirilir?
Entity optimizasyonu ile markanızın kimliğini, özelliklerini ve ilişkilerini netleştirin. Tutarlılık, entity gap audit, schema ve ölçüm adımlarını öğrenin.

Structured Data GEO'yu Nasıl Destekler? Schema ve AI Arama İlişkisi
Structured data GEO'yu nasıl destekler? Schema ile sayfa içeriğinin eşleşmesi, öne çıkan schema türleri, doğrulama adımları ve sık yapılan hatalar.
Markanızı birlikte büyütelim
Ücretsiz ön analiz için bize ulaşın; mevcut hesaplarınızı inceleyip size özel bir yol haritası çıkaralım.